AWS-Datenverlust im Nahen Osten: Warum Cloud kein Backup ersetzt
Am 15. September 2026 hat AWS bestätigt, dass bestimmte Ressourcen und Daten in den Regionen Bahrain und Vereinigte Arabische Emirate nicht mehr wiederhergestellt werden können. Der Vorfall zeigt sehr deutlich, warum Redundanz und Backup zwei unterschiedliche Dinge sind. Stand: 20. September 2026.
DER VORFALL
Was ist bei AWS passiert?
AWS hat am 15. September 2026 in zwei Updates im Health Dashboard bestätigt, dass bestimmte Ressourcen und Daten nicht mehr wiederhergestellt werden können. Vorausgegangen waren schwere physische Schäden an der Infrastruktur im Zusammenhang mit dem Konflikt im Nahen Osten.
Bahrain (me-south-1)
Mehrere Availability Zones waren betroffen. Laut AWS gingen die Schäden über das hinaus, wofür die regionale Multi-AZ-Architektur ausgelegt ist. Ressourcen und Daten, die ausschließlich in dieser Region lagen, lassen sich nicht wiederherstellen.
VAE (me-central-1)
Betroffen ist die Availability Zone mec1-az2. Ressourcen und Daten, die ausschließlich dort lagen, lassen sich nicht wiederherstellen. In den beiden anderen Zonen und in der übrigen Region laufen die Arbeiten weiter.
Seit März
Die Schäden begannen im März 2026. In den VAE wurden laut AWS zwei Einrichtungen direkt getroffen, in Bahrain beschädigte ein Drohnenangriff in unmittelbarer Nähe die Infrastruktur. Im April fiel in Bahrain eine zweite Zone aus, die Region war danach nicht mehr verfügbar.
Kein Totalverlust
AWS hat nicht erklärt, dass alle Kundendaten verloren sind. Die meisten Kunden konnten ihre Systeme in andere Regionen verlagern, mit Backups oder mit Daten, die weiter zugänglich waren.
Was nicht bekannt ist
AWS hat keine Zahl betroffener Kunden, keine Datenmenge und keine vollständige Liste betroffener Dienste genannt.
Wie es weitergeht
Für die VAE will AWS in den kommenden Monaten ein Update zur Wiederherstellung geben, für Bahrain Anfang 2027.
Präzise gesagt: Daten, die ausschließlich in den betroffenen Bereichen lagen und nicht anderweitig gesichert oder repliziert wurden, lassen sich nicht wiederherstellen.
DIE TECHNISCHE LEHRE
Multi-AZ ist kein Backup
Innerhalb einer Region verteilt AWS Workloads auf mehrere Availability Zones. Das ist Hochverfügbarkeit, aber kein Ersatz für ein unabhängiges Backup.
Redundanz
Server → AZ 1 + AZ 2 + AZ 3. Fängt den Ausfall einzelner Rechenzentrumsbereiche ab.
Backup
Produktivsystem → zusätzliche, getrennte Kopie. Schützt vor Defekten, Fehlern und versehentlichem Löschen.
Disaster Recovery
Produktivsystem → Kopie an einem anderen Standort, von dem aus sich die Systeme wiederherstellen lassen.
AWS schreibt in den Well-Architected-Empfehlungen ausdrücklich, dass zusätzlich zur Multi-AZ-Architektur Backups aller nötigen Daten angelegt werden sollten und diese, wo möglich, in eine andere Region kopiert werden. Für Backup, Versionierung und Replikation der eigenen Daten ist laut AWS der Kunde verantwortlich. Wenn ein Ereignis mehrere Availability Zones gleichzeitig betrifft, hilft die Redundanz allein nicht mehr.
FÜR SELBSTHOSTER
Nicht nur fragen: „Habe ich ein Backup?“
Die bessere Frage lautet: Kann ich meine Daten noch wiederherstellen, wenn mein kompletter Serverstandort ausfällt?
Zweites Backup, gleicher Server
Hilft bei einem defekten Laufwerk, aber nicht, wenn der ganze Server ausfällt.
Backup im gleichen Rechenzentrum
Schützt vor bestimmten technischen Fehlern, aber nicht, wenn der Standort selbst ausfällt.
Feuer, Wasser, Strom
Bei Feuer, Wasserschaden, längerem Stromausfall oder einem größeren physischen Ereignis kann der gesamte Standort betroffen sein.
Beispiel: Proxmox
Ein Proxmox Backup Server kann per Sync-Job auf einen zweiten Server an einem anderen Standort replizieren.
Beispiel: verschlüsselte Offsite-Kopie
Werkzeuge wie restic oder BorgBackup sichern verschlüsselt auf einen entfernten Server oder einen Objektspeicher.
Speicherort beachten
Bei personenbezogenen Daten Standort und Anbieter der Zweitkopie mit den Datenschutzvorgaben abstimmen.
UNSER ANSATZ
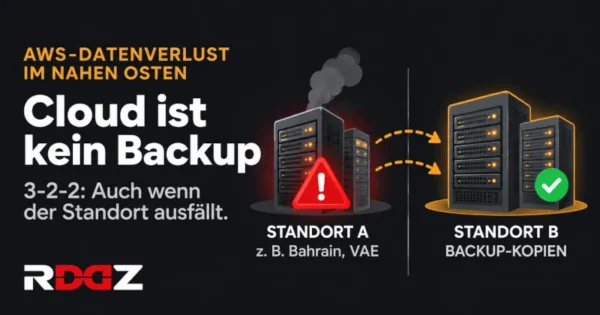
3-2-2: Backups müssen getrennt sein
Genau hier setzt unser 3-2-2-Backup-Konzept an. Der entscheidende Punkt ist die letzte Zahl: Eine Backup-Kopie sollte nicht am gleichen Ort liegen wie das Produktivsystem.
3 Kopien · 2 Speicherziele · 2 Standorte
3 Kopien
Die Daten liegen dreifach vor: im Produktivsystem und in zwei Backups.
2 Speicherziele
Die Kopien liegen auf unterschiedlichen Speicherzielen beziehungsweise Speichermedien.
2 Standorte
Räumlich getrennt: Ein Backup bringt wenig, wenn es beim gleichen Ereignis ebenfalls nicht mehr erreichbar ist.
Beispiel aus dem Hosting
Die produktive Website läuft auf Server A. Eine zusätzliche Sicherung liegt auf einem getrennten Backup-System, eine weitere Kopie an einem anderen Standort. Fällt der Produktivserver aus, lässt sich schnell zurückspielen. Fällt der gesamte Standort aus, steht trotzdem noch eine weitere Kopie zur Verfügung. Bekannt ist auch die 3-2-1-Regel: Bei allen Varianten kommt es auf die räumliche Trennung an.
RESTORE
Backup ist erst gut, wenn Restore funktioniert
Die Sicherung selbst ist kein Beweis, dass eine Wiederherstellung funktioniert. Deshalb gehören regelmäßige Restore-Tests zu einem vernünftigen Backup-Konzept. Dabei sollte geprüft werden:
Vorhanden?
Sind die Backups tatsächlich vorhanden?
Vollständig?
Sind Dateien und Datenbanken vollständig?
Lauffähig?
Lässt sich eine Website oder Anwendung wiederherstellen?
Wie lange? (RTO)
Wie lange dauert der Restore? Die RTO ist die maximal akzeptable Zeit bis zur Wiederherstellung.
Wie viel geht verloren? (RPO)
Wie viel Datenstand geht im schlimmsten Fall verloren? Die RPO ist der maximal akzeptierte Datenverlust, gemessen als Zeit seit dem letzten Wiederherstellungspunkt.
Wer kommt ran?
Ein verschlüsseltes Backup ist wertlos, wenn der Schlüssel nur auf dem ausgefallenen Server liegt. Zugangsdaten und Schlüssel getrennt sichern.
CHECKLISTE
Fragen an Hoster und Cloud-Anbieter
Diese Fragen lassen sich jedem Anbieter stellen, auch dem eigenen Hoster:
FAZIT
Cloud ist nicht automatisch Backup
Der AWS-Vorfall bedeutet nicht, dass AWS grundsätzlich unsicher ist. AWS bietet umfangreiche Mechanismen für Hochverfügbarkeit und Disaster Recovery an. Gerade deshalb ist die Aussage interessant: Auch eine sehr große, redundant aufgebaute Cloud-Infrastruktur hat einen definierten Schutzbereich.
Cloud ist nicht automatisch Backup. Redundanz ist nicht automatisch Backup. Und ein Backup ist erst dann etwas wert, wenn es sich wiederherstellen lässt.
Für uns als Hosting-Anbieter ist die Konsequenz klar: Ein Backup sollte nicht vom gleichen Fehler betroffen sein können wie das Produktivsystem. Für professionelle Hosting-Umgebungen zählt deshalb die Kombination aus mehreren Kopien, getrennten Speicherzielen, räumlicher Trennung und regelmäßigen Restore-Tests. Unser 3-2-2-Ansatz verfolgt genau dieses Ziel: Wenn der Produktivstandort ausfällt, soll nicht auch die letzte Sicherung verschwunden sein.
FAQ
Häufige Fragen zum AWS-Vorfall
QUELLEN
Quellen und Links
- AWS Health Dashboard
- Reuters: Amazon unable to restore access to Bahrain facility (via NWA Democrat-Gazette)
- Help Net Security: AWS-Updates vom 15. September 2026
- AWS Well-Architected: REL13-BP02, Wiederherstellungsstrategien
- AWS-Whitepaper: Disaster recovery options in the cloud
- AWS Well-Architected: Disaster Recovery Objectives (RPO und RTO)
Backup nicht dem Zufall überlassen?
Ein Backup sollte nicht vom gleichen Fehler betroffen sein wie das Produktivsystem. Sprechen Sie uns zu Webhosting und Backup an.

